Investissement matériel
Coût complet du serveur bi-GPU (2x RTX 5090 - 64 Go VRAM) capable d'exécuter des modèles jusqu'à 70 milliards de paramètres.
« Loin des effets d’annonces et des benchmarks spectaculaires, nous avons souhaité mettre en œuvre une IA qui soit souveraine, frugale et utile. Et pour cela, rien de tel que le test réel. »
Faire tourner un modèle de langage sur ses propres serveurs garantit la confidentialité des données. Mais à quel coût énergétique et avec quelle précision ? Pour répondre avec des faits mesurés, nous avons assemblé un serveur dédié bi-GPU et soumis les modèles à 75 questions métiers.
Coût complet du serveur bi-GPU (2x RTX 5090 - 64 Go VRAM) capable d'exécuter des modèles jusqu'à 70 milliards de paramètres.
Taux de succès obtenu par GPT-OSS 20b sur les tâches d'entreprise (raisonnement, documents, code, traduction hors web direct).
Consommation mesurée à la prise pour GPT-OSS 20b (soit 0,10 gCO2e par réponse), 11 fois moins qu'un grand modèle cloud.
Temps de réaction moyen constaté en lançant 10 demandes simultanées pour GPT-OSS 20b (et < 60 ms pour Mistral Small 24b).
Les organisations souhaitent intégrer l'intelligence artificielle sans envoyer leurs données stratégiques vers des prestataires tiers. Mais deux freins reviennent souvent : la crainte d'une facture d'électricité incontrôlée et le doute sur la précision des modèles de taille moyenne.
Notre démarche s'appuie sur trois exigences simples :
1. S'affranchir du contexte géopolitique : Le contexte international est porteur d'incertitudes juridiques et de dépendance technologique (extraterritorialité du droit américain) et ne permet pas de garantir la souveraineté de vos données.
2. Garantir un coût stable et maîtrisé : Le modèle économique des géants de l'IA reste à ce jour déficitaire (OpenAI, Anthropic ou Perplexity perdent des milliards). Une augmentation des coûts est inéluctable à terme, et la tendance haussière est d'ailleurs déjà amorcée. Disposer de son IA en local permet de s'affranchir de ce risque.
3. Personnalisation avancée des données : Le déploiement local permet de personnaliser l'IA pour un meilleur rendu. La réponse de l'IA locale devient ainsi plus précise et personnalisée et tout en garantissant que vos données restent chez vous.
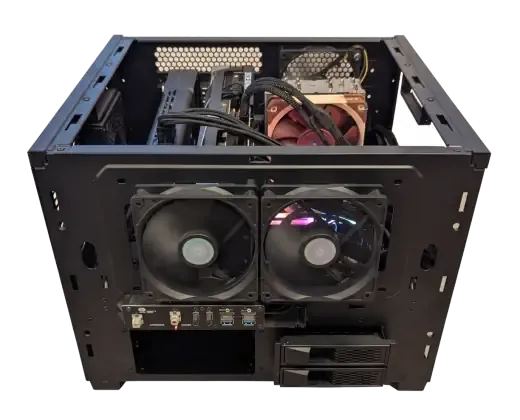
Le serveur de test assemblé et instrumenté dans les locaux d'IDfr (Besançon)
| Composant | Spécification | Montant HT |
|---|---|---|
| Cartes graphiques | 2x NVIDIA RTX 5090 (32 Go VRAM chacune, 64 Go au total) | 4 268 € |
| Processeur | Intel Core Ultra 9 285K (24 cœurs, jusqu'à 5,7 GHz) | 604 € |
| Carte mère | ASUS Prime B860-PLUS WiFi (bus PCIe 5.0) | 178 € |
| Mémoire vive | 64 Go DDR5 5200 MT/s Kingston FURY Beast | 150 € |
| Stockage | SSD NVMe P310 2 To PCIe Gen4 (7 100 Mo/s) | 106 € |
| Alimentation | Corsair HX1500i modulaire 1500W Platinum | 231 € |
| Châssis & ventilation | Noctua NF-F12, accessoires et câblage PCIe | 193 € |
Prise connectée AwoX mesurant la puissance instantanée toutes les 500 millisecondes directement à la prise 230V et transmise vers Grafana. Suivi GPU par NVIDIA-SMI, suivi CPU par Scaphandre et moteur d'inférence Ollama sous Linux Ubuntu.
Nous avons rédigé 75 questions, ainsi que la réponse correcte, afin de pouvoir tester les modèles sur des usages concrets et réels. L'idée était de prendre des cas d'usage représentatifs de l'entreprise et d'évaluer le comportement précis des modèles face à ces situations. Les questions ont été réparties en 7 catégories :
Moyenne obtenue sur les questions posées à chaque modèle, exécutées dans des conditions logicielles et matérielles strictement identiques :
| Modèle | Taille | Précision | Vitesse | Tokens / rép. | Temps moy. | Énergie / q. | Émissions CO2e |
|---|---|---|---|---|---|---|---|
| OpenAI gpt-oss Recommandé | 20b (MXFP4) | 79 % | 208 t/s | 2 079 t | 13 s | 0,0018 kWh | 0,10 g |
Ce modèle traite une question en 13 secondes à 208 tokens/seconde avec une dépense de seulement 0,0018 kWh (0,10 gCO2e).
En écartant la recherche d'actualités directes où tous les modèles sans moteur web butent, sa note grimpe à 89 %.
Intégration des données de fabrication (estimées via Boavizta) et de la consommation réelle :
| Régime d'utilisation | Puissance | Consommation | Émissions usage | Émissions fabrication* | Coût élec. | Bilan sur 5 ans |
|---|---|---|---|---|---|---|
| Serveur au repos (2x RTX 5090 sans requête) |
85,8 W | Jour : 2,1 kWh An : 744 kWh |
37 kgCO2e/an | 660 kgCO2e | 148 €/an | 850 kgCO2e 78 % Fab. / 22 % Usage |
| Activité IA (10h/j) (gpt-oss 20b en charge) |
750 W en pic | Jour : 8,6 kWh An : 3 171 kWh |
158 kgCO2e/an | 660 kgCO2e | 634 €/an | 1 450 kgCO2e 45 % Fab. / 55 % Usage |
* Émissions de fabrication estimées via l'outil Boavizta (https://dataviz.boavizta.org/serversimpact).
Avec les hypothèses de charge et GPT-OSS 20b, notre serveur consomme 1,7 fois plus (+70 %) avec un usage IA intensif sur 5 ans en intégrant l'intégralité du cycle de vie.
Temps moyen mesuré avant réception du premier octet (TTFT) selon le nombre de requêtes simultanées :
| Modèle testé | Threads | 1 user | 5 users | 10 users | 30 users |
|---|---|---|---|---|---|
| GPT-OSS 20b | 10 // | 1,54 s | 3,99 s | 5,89 s | 15,91 s |
| Mistral Small 24b | 6 // | 0,041 s | 0,056 s | 0,057 s | 0,065 s |
| Qwen 3 30b | 6 // | 8,0 s | 20,0 s | 23,0 s | 28,0 s |
| Google Gemma 3 27b | 6 // | 16,0 s | 22,0 s | 30,0 s | 34,0 s |
Tests réalisés sur 180 secondes avec la question type : « Traduis en français : UK car industry in brace position ahead of Brexit deadline ».
1. Configuration d'Ollama : Par défaut, le moteur ne traite qu'une requête à la fois. Régler la variable OLLAMA_NUM_PARALLEL est indispensable pour éviter les erreurs de délai dépassé (504 Timeout).
2. La stabilité de Mistral : Mistral Small 24b encaisse la charge avec une grande régularité. Même sous 30 appels simultanés, le temps de réaction reste sous 65 millisecondes.
3. GPT-OSS 20b en entreprise : Avec 10 requêtes parallèles, la latence moyenne reste sous 6 secondes pour 10 utilisateurs simultanés.
Créée en 1999 et labellisée B-Corp depuis 2019, IDfr est une agence de développement web de moins de 10 personnes située à Besançon. Nous faisons depuis longtemps le choix de l'éco-conception pour nos développements internes (Wysistat, outil de mesure d'audience respectueux de la vie privée — GDC, gestion de candidatures) et pour nos clients.
Nous réalisons notre bilan Carbone chaque année depuis bientôt 10 ans avec pour objectif continu de réduire nos émissions (déplacements, hébergement, serveurs).
Dès 2024, nous avons massivement testé et investi dans les architectures d'IA afin de forger une expertise éclairée et indépendante.
Nous nous sommes dotés d'une charte d'usage interne stricte encadrant l'utilisation raisonnée de ces outils : refuser le gaspillage de ressources, prioriser la souveraineté et vérifier systématiquement les retours d'inférence.
Accédez au document technique complet de 10 pages comprenant les graphiques de charge, les données d'analyse du cycle de vie (ACV) et nos préconisations d'achat matériel.
Indiquez votre adresse email professionnelle pour recevoir directement le livre blanc technique en PDF :
Notre machine de test équipée de 2 cartes NVIDIA RTX 5090 et d'un processeur Intel Core Ultra 9 consomme 85,8 W en veille (sans requête active). Cela représente une facture annuelle d'environ 148 € à l'arrêt.
En inférence 10 heures par jour avec le modèle GPT-OSS 20b, le serveur consomme environ 8,6 kWh par jour (soit 206 kWh par mois). Le coût annuel d'électricité s'établit à 634 € (environ 53 € par mois), avec une empreinte annuelle d'usage de 158 kgCO2e.
En intégrant les émissions de fabrication (660 kgCO2e estimées via Boavizta), le serveur au repos totalise 850 kgCO2e sur 5 ans (78 % fabrication, 22 % usage). En activité continue 10h/jour, le bilan atteint 1 450 kgCO2e (45 % fabrication, 55 % usage), soit 1,7 fois plus (+70 %) qu'un serveur classique.
Si la taille du modèle excède la mémoire vidéo des cartes graphiques, le système décharge une partie du calcul sur la mémoire vive (RAM) de la carte mère. La vitesse de transfert s'effondre alors d'un facteur 5 à 10, rendant l'usage impraticable pour une équipe.